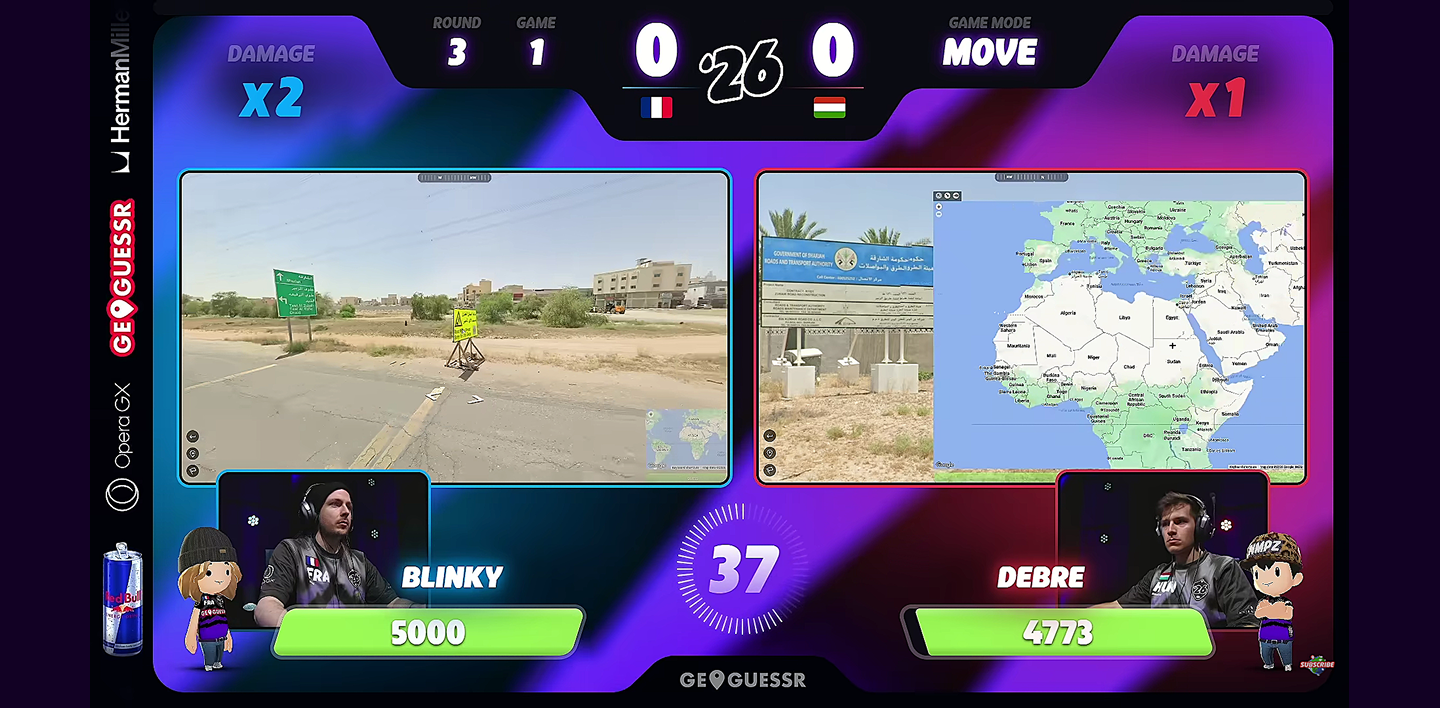
S otto le luci stroboscopiche del Tempodrom di Berlino l’ungherese Szabolcs Attila Debre, ventun anni, e il francese Mathieu “Blinky” Huet, ventisette, stanno fissando immobili i loro monitor mentre duemila spettatori trattengono il fiato sugli spalti. Gli schermi di Debre e Blinky mostrano un singolo fotogramma statico e sgranato, una pista di terra battuta fiancheggiata da cespugli radi sotto un cielo lattiginoso. Siamo al tie break della finale del campionato mondiale 2026 di GeoGuessr, un videogioco (o meglio: un eSport) basato su una sola regola, semplice e spietata: i giocatori (o meglio: gli “atleti”) vengono catapultati in un punto casuale di Google Street View e devono indovinarne le coordinate esatte su una mappa del mondo. Vince, naturalmente, chi si avvicina di più al bersaglio reale.
Né Blinky, già campione del mondo 2024, né Debre, vicecampione l’anno successivo, sono nuovi a una simile pressione. Ma questa finale, al meglio delle cinque partite, si è trasformata in una guerra di nervi: dopo che il francese si è aggiudicato con apparente facilità i primi due set, l’ungherese ha infilato una sequenza implacabile di pronostici perfetti (che la comunità chiama “5K”, cinquemila punti: vuol dire avvicinarsi a non più di venticinque metri dalla soluzione), riportando il punteggio sul due pari. Ora, nell’ultimo spareggio, entrambi scrutano freneticamente l’immagine alla ricerca di indizi: la composizione chimica e cromatica del suolo, la morfologia degli arbusti, l’inclinazione dei raggi solari.
Dopo appena dieci secondi, Debre punta il nord della Namibia, e il suo click fa scattare un conto alla rovescia di quindici secondi per Blinky, che posiziona d’istinto il cursore in Sudafrica salvo poi spostarlo, proprio allo scadere del tempo, nel cuore dell’Argentina. È una scena rarissima per una finale di un campionato mondiale, in cui di solito le sfide si decidono sul filo dei chilometri piuttosto che su continenti diversi. Quando il maxischermo rivela la soluzione, la rimonta di Debre è compiuta: il suo segnalino è atterrato a circa 240 chilometri dal luogo dello scatto, a fronte degli oltre 8.000 di Blinky. Il titolo mondiale è suo.
Da passatempo enigmistico per lettori colti, la geolocalizzazione fotografica è diventata uno strumento forense cruciale per il giornalismo investigativo e uno dei problemi più affascinanti e complessi dell’informatica contemporanea.Osservato più da vicino, lo spettacolo appena andato in scena nell’arena berlinese somiglia a un esperimento estremo di semiotica applicata e scienze cognitive. Il tipo di problemi con cui si sono cimentati Debre, Blinky e colleghi, in realtà, non è nuovissimo: già nel 1906 l’esploratore americano Frederick Cook sostenne di essere stato il primo essere umano a raggiungere la vetta del monte Denali, in Alaska (uno dei luoghi recentemente colpiti dal sovranismo toponomastico di Trump, che gli ha reimposto il nome McKinley), esibendo uno scatto fotografico come prova, e fu proprio l’analisi topografica di quell’immagine, condotta diversi decenni più tardi, a mostrare che era in realtà stata ripresa da una cima secondaria. Da passatempo enigmistico per lettori colti, come lo storico concorso Where are you? lanciato da Condé Nast Traveler nel 1993, la geolocalizzazione fotografica è diventata oggi uno strumento forense cruciale per il giornalismo investigativo (ne fanno largo uso, per esempio, le comunità OSINT, Open Source Intelligence, come Bellingcat) e uno dei problemi più affascinanti e complessi dell’informatica contemporanea.
La storia di GeoGuessr comincia nel maggio del 2013, quando Anton Wallén, progettista software svedese, inizia a smanettare con le API (Application Programming Interface) di Google Maps appena rilasciate e mette a punto un piccolo gioco per browser, che poi pubblica su Reddit. “Il gioco divenne immediatamente virale, e da quel momento è iniziato un lungo viaggio”, racconta a Berlino Mikael Falgard, Head of Esports di GeoGuessr. Dopo il passaggio al modello in abbonamento nel 2019, reso necessario dall’aumento dei costi di accesso alle API di Google, e la creazione della prima Coppa del Mondo a Stoccolma nel 2023 (e la successiva ristrutturazione del circuito professionistico due anni più tardi), la piattaforma ha superato i cento milioni di utenti registrati, con un’utenza giovane (la fascia media di età è tra i 16 e i 24 anni) distribuita dagli Stati Uniti all’Europa occidentale fino al recente boom del Giappone.
Secondo Falgard, il segreto di questo successo sta nella combinazione di “universalità tematica” e trasparenza cognitiva del gioco: “Nella maggior parte degli eSport bisogna giocare per mesi solo per capire cosa stia succedendo sullo schermo; qui basta dare una rapida occhiata e chiunque comprende perfettamente qual è la sfida”, mi spiega. “È un gioco sull’esplorazione del mondo, certo, ma è soprattutto un puzzle in cui si devono mettere insieme frammenti di informazione, come il lato di guida delle automobili o la posizione del Sole. E a tutti, in fondo, piace giocare al detective”.
Nella maggior parte degli eSport bisogna giocare per mesi solo per capire cosa stia succedendo sullo schermo; qui basta dare una rapida occhiata e chiunque comprende perfettamente qual è la sfida.Per diventare i Maigret della geografia, comunque, l’intuito non basta. I professionisti devono spingere la capacità di osservazione ben oltre i confini del senso comune, e le partite “tradizionali” culminano presto in sfide ancora più estreme, rigorosamente giocate in streaming davanti a centinaia di migliaia di spettatori, come indovinare un luogo da immagini in bianco e nero mostrate per appena un decimo di secondo, o dalla trama di un guardrail, o persino bendati, ascoltando la descrizione dello schermo fatta da un compagno. Nella pratica quotidiana, che per un campione come Blinky significa quattro o cinque ore di allenamento intensivo ogni giorno, il mondo viene dissezionato secondo una rigorosa gerarchia analitica. “Si parte quasi sempre da una strada, quindi la carreggiata stessa è il primo grande indizio: guardo le linee sull’asfalto, la segnaletica, le infrastrutture elettriche come i pali della luce, e solo in seconda battuta passo alla vegetazione”, mi spiega il francese poco prima di salire sul palco per la finale.
I campioni catalogano meticolosamente nel proprio palazzo della memoria la forma dei cassonetti dei rifiuti, gli alfabeti, i prefissi telefonici e i domini web nazionali presenti sui cartelloni pubblicitari; sanno quale prefettura giapponese monta targhette rotonde sui tralicci; associano istantaneamente una targa verde brillante alle auto elettriche della Norvegia; riconoscono un’autostrada dell’Australia occidentale dalla foggia dei paletti a bordo strada (“Solo lì sono zebrati”, mi spiega Greta “Nemisky” Narduzzi, giocatrice professionista della delegazione italiana ai campionati mondiali).
Dopo migliaia di ore di esposizione, questa scansione della realtà si fissa inesorabilmente nell’inconscio. “Il cervello ha compiuto quest’analisi così tante volte”, dice ancora Blinky, “che la esegue in un battito di ciglia, in una frazione di secondo, prima ancora che la si possa razionalizzare”. Un processo così comune da avere un nome: nella comunità è conosciuto come vibe guessing, un’astrazione percettiva per cui, anche senza riconoscere ogni singolo dettaglio dell’immagine, il giocatore coglie istintivamente l’accordo cromatico tra le texture dell’asfalto, l’opacità del cielo e il verde del fogliame. È la traduzione empirica di un meccanismo ben noto alle neuroscienze della visione: come hanno dimostrato Aude Oliva e Antonio Torralba del MIT, l’occhio umano è in grado di estrarre l’essenza globale di un ambiente (il cosiddetto gist) in meno di un quinto di secondo, ben prima di aver identificato i singoli oggetti che lo compongono, affidandosi a un “riassunto statistico” delle proprietà d’insieme dell’immagine (dalla distribuzione delle macchie di colore all’orientamento dei contorni fino al grado di apertura e ruvidità dello spazio) che gli scienziati definiscono involucro spaziale (spatial envelope).
C’è dell’altro: per decodificare il pianeta, i GeoGuessers si affidano anche a un secondo livello, più profondo ed epistemologicamente scivoloso, il cosiddetto meta. Oggi il termine viene usato dalla comunità per indicare qualsiasi indizio che guidi verso la soluzione, ma fino a qualche tempo fa definiva esclusivamente gli artefatti tecnici legati all’automobile e alla telecamera di Google: i professionisti memorizzano le diverse generazioni di sensori ottici, ciascuna caratterizzata da specifiche aberrazioni cromatiche, aloni di sfocatura, graffi sulle lenti o ombre proiettate dall’antenna sul cofano. “Se notiamo che la Google Car ha specchietti sporgenti che somigliano a piccole orecchie”, dice ancora Nemisky, “sappiamo all’istante che ci troviamo a Sisimiut, sulla costa occidentale della Groenlandia”. Lo strumento, insomma, finisce per sovrapporsi al territorio fino a sostituirlo. “Se vedessi una fotografia ‘normale’ del mondo, avrei molte più difficoltà a capire dove è stata scattata”, ammette Blinky, “perché mi mancherebbero gli indizi meta legati all’auto, al copyright e alla stagione in cui Google ha mappato quella strada”.
Per quasi vent’anni, insegnare a un computer a indovinare dove fosse stata scattata una fotografia qualsiasi è stato un problema molto arduo.Per evitare che il gioco si riduca a uno sterile (e forse meno interessante) esercizio di memorizzazione degli artefatti ‒ un rischio simile a quello che spinse il grande maestro di scacchi Bobby Fischer a inventare la variante Chess960, rimescolando la posizione iniziale dei pezzi per neutralizzare lo studio mnemonico delle aperture e privilegiare l’intelligenza analitica pura ‒, il gioco si affida paradossalmente alla natura mutevole dell’archivio di Google: man mano che le auto di Mountain View aggiornano la copertura stradale, cambiano l’altezza delle fotocamere o aggiungono nuovi Paesi (arrivando persino a mappare i fondali corallini sottomarini, usati come prova estrema durante la coppa del mondo), l’enciclopedia mentale dei giocatori deve essere riscritta da zero, o quantomeno pesantemente aggiornata.
Eppure, è proprio questa dipendenza dai dettagli microscopici dell’immagine digitale ad aver preparato il terreno per l’ingresso in scena di un avversario non umano. Per quasi vent’anni, e ben prima della creazione di GeoGuessr, insegnare a un computer a indovinare dove fosse stata scattata una fotografia qualsiasi è stato un problema molto arduo. Il primo tentativo moderno, il sistema IM2GPS sviluppato nel 2008 da James Hays e Alexei Efros, affrontava questa sfida affidandosi al recupero di immagini simili (il cosiddetto nearest-neighbor retrieval) affiancate per caratteristiche visive codificate a mano, un approccio naturalmente non scalabile all’intero globo.
Poi, nel 2016, è arrivato PlaNet di Google, che usava le reti neurali convoluzionali (architetture di deep learning ispirate alla corteccia visiva biologica, che scansionano l’immagine attraverso una gerarchia di filtri matematici estraendo prima bordi e variazioni di colore e poi forme e pattern via via più complessi) per “classificare” le immagini, suddividendo la superficie terrestre in una griglia di celle geografiche discrete e chiedendo alla macchina di assegnare la foto alla casella giusta. Entrambi i modelli, tuttavia, soffrivano di limiti strutturali, dal momento che il primo tendeva a funzionare bene quasi solo davanti a immagini “riconoscibili” (per esempio con monumenti noti) e il secondo utilizzava partizioni geometriche troppo arbitrarie, tagliando il mondo in rettangoli ciechi che ignoravano i confini politici e naturali e trattavano ogni cella come una monade, senza sapere quali regioni fossero adiacenti.
Il vero “momento Deep Blue” di GeoGuessr, per restare nella metafora scacchistica, è arrivato nel 2024 grazie al lavoro di quattro ricercatori dell’Università di Stanford che hanno presentato PIGEON (Predicting Image GEOlocatioNs) e il suo gemello generalista PIGEOTTO. Per costruire PIGEON, il gruppo ha estratto da GeoGuessr un dataset originale di 100.000 posizioni globali, scaricando per ciascuna un panorama a 360 gradi composto da quattro immagini, e ha innestato su una rete multimodale di OpenAI quattro innovazioni rispetto a PlaNet: la creazione di celle “semantiche” anziché geometriche, basate su confini politici o geografici (in questo modo targhe, segnaletica e infrastrutture sono raggruppate più coerentemente all’interno di ogni cella); il calcolo di un gradiente di probabilità per celle adiacenti (che insegna al modello la “continuità geografica” del pianeta); l’inferenza di parametri e variabili ausiliari (il mese dello scatto, la zona climatica, l’altitudine, la direzione della bussola e altro); l’inserimento di un meccanismo di recupero gerarchico che confronta la rappresentazione matematica dell’immagine con quella dei cluster più verosimili.
Nel 2024 quattro ricercatori dell’Università di Stanford hanno presentato PIGEON (Predicting Image GEOlocatioNs), un modello IA che ha dimostrato di superare agevolmente i giocatori umani.Con questa dotazione – ancora una volta, in modo simile a come successo negli scacchi – la macchina ha agevolmente superato l’essere umano. Su un campione di test di 5.000 località mai viste prima, PIGEON ha indovinato il Paese esatto in oltre il 91% dei casi, piazzando il 40% dei suoi pronostici entro un raggio di 25 chilometri dal bersaglio e facendo registrare un errore mediano globale di appena 44 chilometri. Schierato (in incognito) tramite un bot su 458 partite contro giocatori umani, il modello si è posizionato stabilmente nello 0,01% mondiale (la Champion Division); infine, in una partita storica trasmessa in diretta streaming, ha sfidato Trevor Rainbolt, il più celebre giocatore professionista del web, battendolo in sei partite su sei.
Una vittoria tout court, o quasi: in un settimo round extra, Rainbolt è riuscito alfine ad avere la meglio sulla macchina, ma per farlo ha dovuto restringere artificialmente il campo da gioco a una mappa rurale di un solo Paese, il Laos, nella speranza di bilanciare la “potenza di fuoco globale” dell’intelligenza artificiale con la sua conoscenza molecolare di tutte le strade della nazione asiatica. Il dettaglio più interessante, però, è emerso dopo la partita, quando Rainbolt e i creatori di PIGEON hanno ispezionato le mappe di attenzione della rete neurale per comprendere su cosa si fosse concentrata, scoprendo che per localizzare una regione del Canada, per esempio, il sistema aveva ignorato alberi, strada e forma dei segnali stradali e si era focalizzato unicamente su una macchia di sporco sulla lente della telecamera di Google: la macchina, in sostanza, aveva scoperto da sola il meta.
La qualità del ragionamento della macchina è notevolmente inferiore: l’algoritmo riesce a indovinare il luogo ma fatica a spiegare il come. Mentre il giocatore umano osserva i singoli dettagli per costruire un’ipotesi, i VLM saltano alla conclusione statistica “più probabile” e poi cercano di giustificarla a posteriori.Archiviato questo successo, il passaggio successivo della comunità scientifica è stato cercare di ricostruire quantitativamente il percorso logico che seguono questi sistemi (e gli esseri umani) per arrivare alla soluzione. Nell’aprile del 2026, un gruppo di ricercatori del Georgia Institute of Technology ha pubblicato lo studio “GeoRC: A Benchmark for Geolocation Reasoning Chains”, tra i cui coautori ci sono anche tre giocatori d’élite di GeoGuessr, cui è stato chiesto di redigere 800 “catene di ragionamento” esplicitando passo passo ogni attributo visivo utilizzato per geolocalizzare un’immagine. Da questa prima analisi è emerso che i campioni procedono per deduzione (dal generale al particolare) combinando indizi che definiscono “fortemente diagnostici” (nell’ordine: infrastrutture generali ed elettriche, vegetazione, architettura, morfologia del terreno, clima, meta, veicoli, geologia).
Successivamente, gli scienziati hanno posto la stessa domanda a diversi modelli di intelligenza artificiale “generalisti” (Gemini, GPT, Llama, Qwen), usando lo stesso dataset di immagini: la qualità del ragionamento della macchina, misurata attraverso un punteggio che tiene conto della precisione degli indizi citati, è notevolmente inferiore a quella umana, nel senso che l’algoritmo riesce a indovinare il luogo ma fatica a spiegare il come. Secondo gli autori del lavoro, la motivazione sta nel fatto che mentre il giocatore umano osserva i singoli dettagli per costruire un’ipotesi, i VLM (Vision Language Models) saltano direttamente alla conclusione statistica “più probabile” e poi cercano di giustificarla a posteriori, per esempio attribuendo un’esclusività inesistente a un certo elemento (in un caso, Gemini ha falsamente identificato un paletto stradale come “esclusivamente tedesco”) o addirittura inventando dettagli assenti nell’immagine per puntellare la propria tesi.
C’è ancora un punto fondamentale sollevato dagli autori di PIGEON. “La geolocalizzazione delle immagini”, scrivono nello studio, “potrebbe avere dei rischi, specie se la precisione di questi sistemi continua a migliorare. Per quel che sappiamo, il nostro è il primo lavoro allo stato dell’arte in questo settore che non è finanziato da contratti militari. Altri lavori recenti sono stati supportati da fondi del Dipartimento della Difesa e dall’esercito degli Stati Uniti. Ogni tentativo di sviluppare tecnologie di questo tipo a scopo militare dovrebbe essere valutato attentamente. E ci sono anche rischi per la privacy: per esempio, è stato mostrato che alcuni sistemi sono in grado di inferire reddito, etnia, livello di istruzione e orientamento di voto di un quartiere”.
Lo sviluppo dei sistemi di geolocalizzazione delle immagini potrebbe comportare dei rischi, soprattutto considerando che molti di questi sistemi sono finanziati da contratti militari.Per questi motivi, i ricercatori di Stanford hanno deciso – per ora – di non rendere pubblici i pesi del loro modello. Probabilmente, però, i buoi sono già scappati: un altro lavoro presentato a una conferenza specializzata nel 2024 ha mostrato che basta un modello commerciale e un prompt appropriato (il cosiddetto least-to-most, che forza l’algoritmo a stimare a cascata Paese, città, quartiere, edificio e coordinate) per localizzare a livello della singola strada, cioè entro un chilometro circa, il 23,9% delle foto del test IM2GPS. Per misurare e tentare di arginare questo rischio, lo stesso gruppo di ricercatori ha costruito GPTGeoChat, un database di circa mille conversazioni tra annotatori umani e GPT-4v su fotografie che simulano post sui social media, dalla cui analisi è emersa una capacità di deduzione impressionante.
Davanti alla foto di un chiosco ambulante, il modello legge sul menu il prefisso telefonico “504” e l’offerta di “Charbroiled oysters”, deducendo che lo scatto è stato realizzato a New Orleans; davanti a un prato del Texas con alcuni cartelli elettorali (Julie Johnson, John Biggan, Etta Mullin), incrocia i confini del 115° distretto della Camera statale con il 24° distretto congressuale e restringe la posizione alla città di Irving, nella contea di Dallas; osservando la scritta “Schlappeseppel Brau seit 1631” su un lampione, risale a uno storico birrificio di Aschaffenburg, in Baviera, fornendone le coordinate. Sembra proprio che, a forza di addestrare algoritmi e cervelli a decifrare ogni crepa dell’asfalto, ogni palo elettrico e ogni macchia sulle lenti, abbiamo trasformato l’intero paesaggio terrestre in un testo indicizzato. Con tutti i rischi che ne conseguono.